Jede Woche bringt neue Schlagzeilen, die sich auf „eine neue Studie“ stützen. Manche dieser Studien sind wirklich starke Evidenz. Andere sind ein einzelner kleiner Versuch, ein Tierexperiment oder eine Beobachtungsstudie – dargestellt mit deutlich mehr Gewissheit, als die Daten hergeben. Den Unterschied zu erkennen, braucht kein Forschungsstudium, sondern nur eine Handvoll Fragen, bevor man einer Behauptung vertraut.
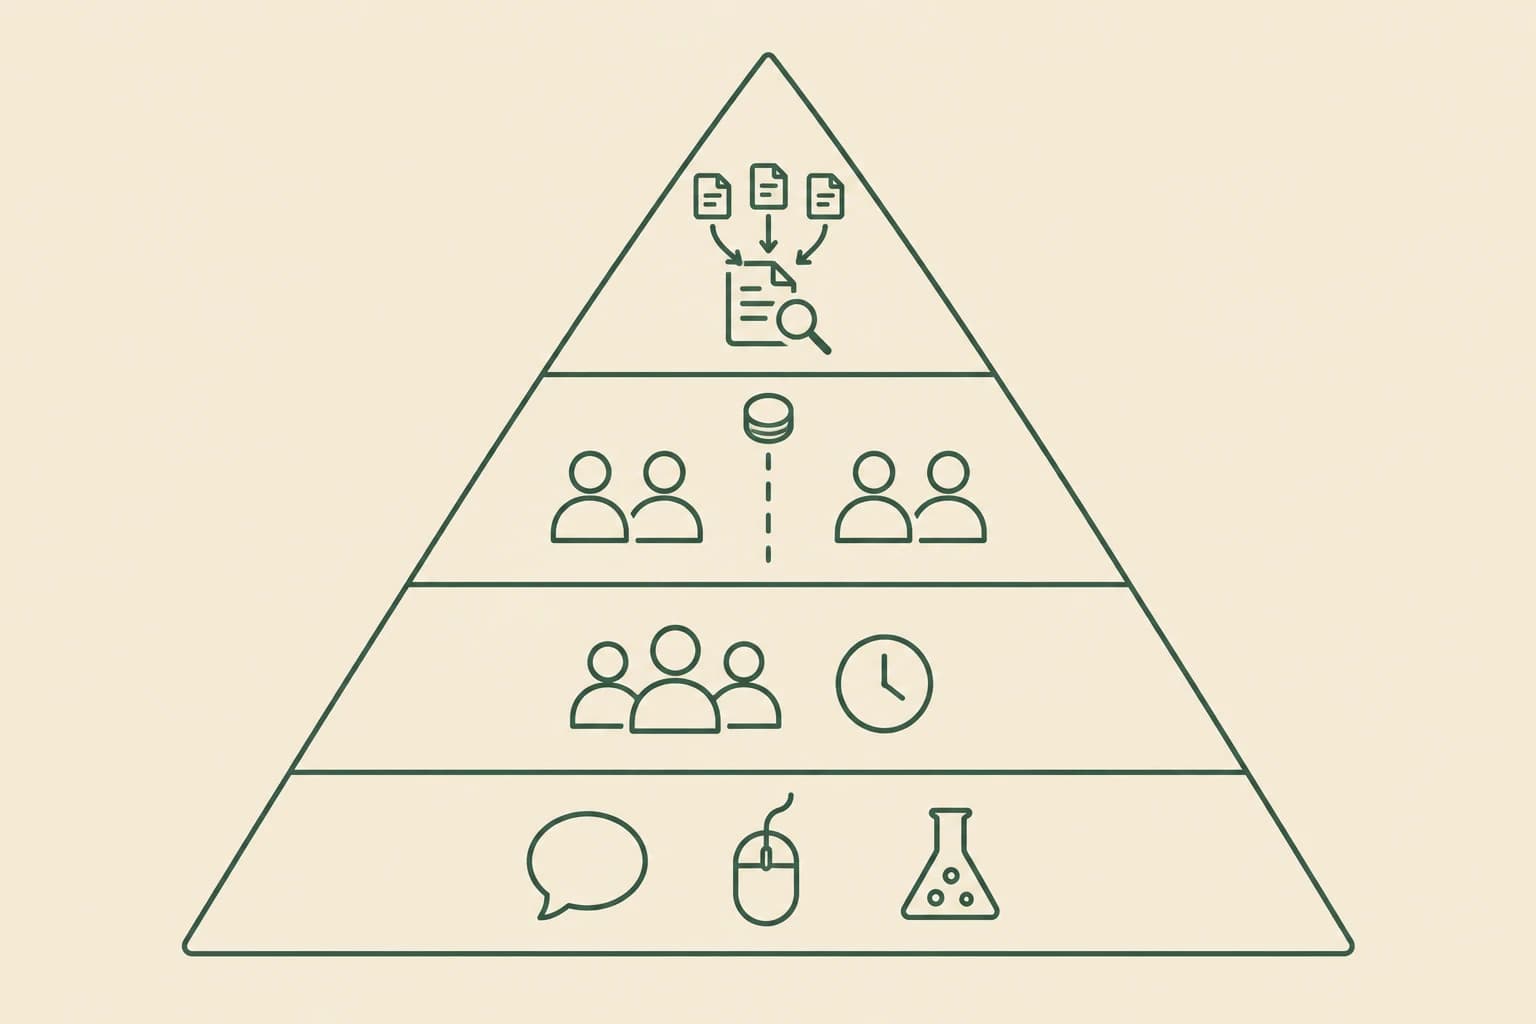
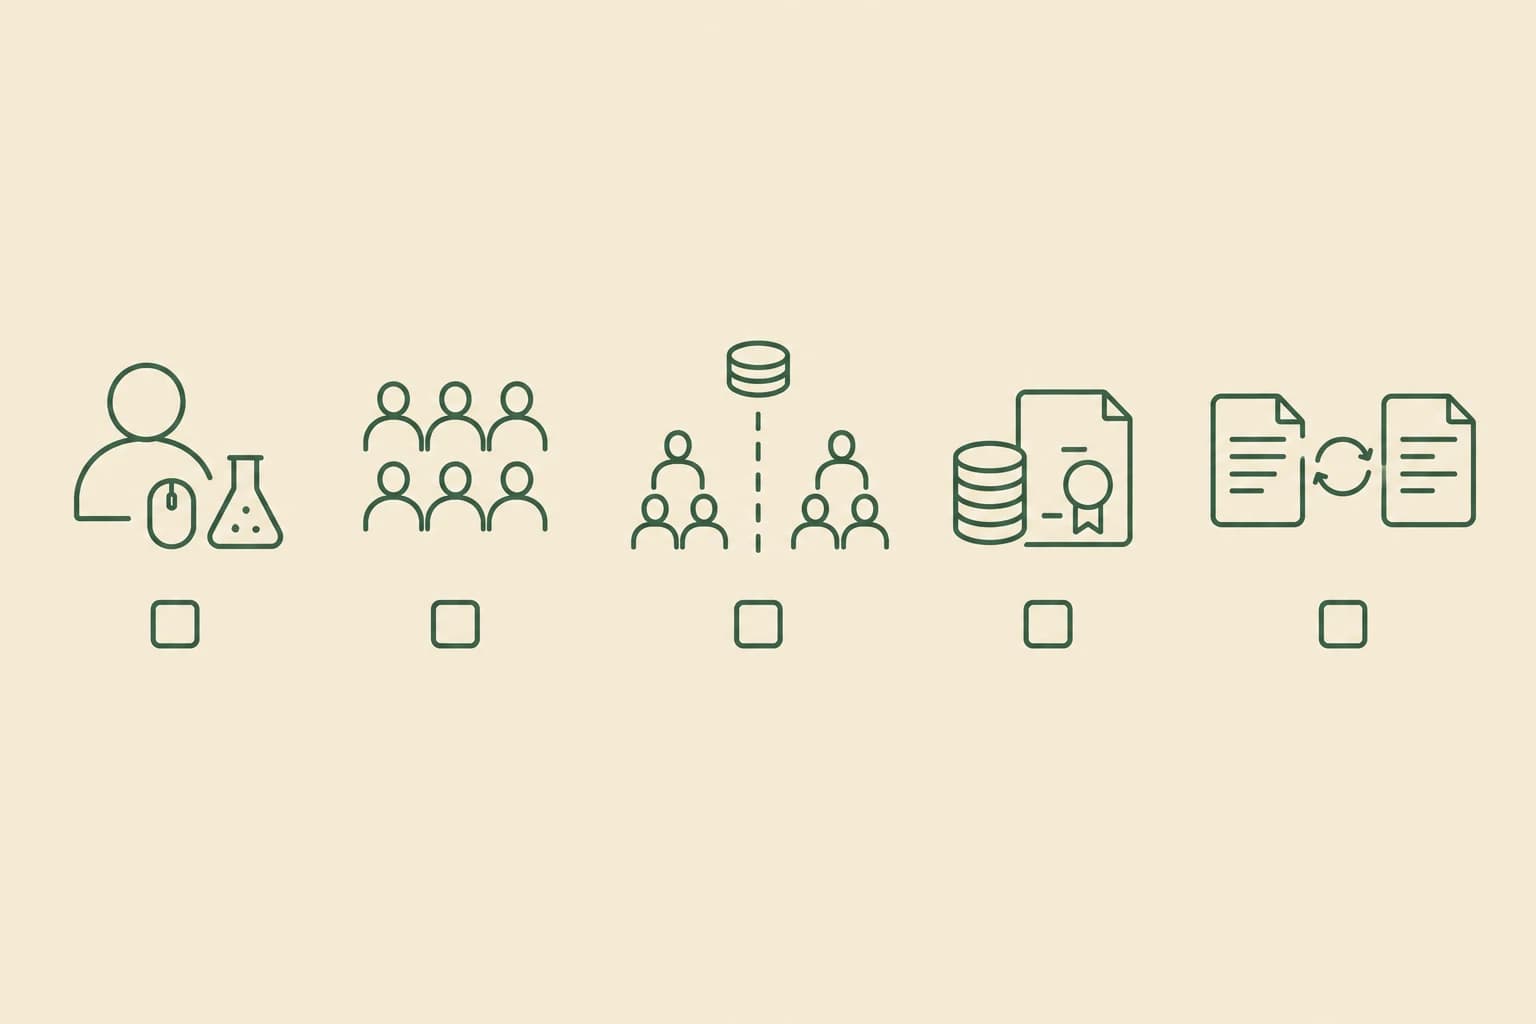
Kurz zusammengefasst: Die Qualität von Evidenz folgt einer groben Stufenleiter. Anekdoten und Expertenmeinungen stehen ganz unten – nützlich, um eine Idee zu entwickeln, nicht um sie zu bestätigen. Beobachtungsstudien stehen darüber: Sie zeigen, dass zwei Dinge zusammenhängen, können aber andere Erklärungen nicht ausschließen. Randomisierte kontrollierte Studien (RCTs) sind stärker, weil die zufällige Zuteilung Unterschiede zwischen den Gruppen ausgleicht – auch solche, an die niemand gedacht hat. Ganz oben stehen systematische Übersichtsarbeiten und Metaanalysen, die mehrere unabhängige Studien zu einer verlässlicheren Schätzung zusammenführen. Fünf kurze Fragen – Mensch, Tier oder Reagenzglas; wie viele Teilnehmende; randomisierte Kontrollgruppe oder nicht; wer hat finanziert; wurde es repliziert – verraten mehr über das tatsächliche Gewicht einer Studie als jede Schlagzeile.
Warum das wichtig ist
Eine Schlagzeile und eine Studie sind nicht dasselbe. Bis ein Befund eine Schlagzeile oder eine Produktseite erreicht, wurde er meist vereinfacht, oft über das hinaus, was die Daten hergeben: Eine Korrelation wird zur Ursache, ein Ergebnis bei Mäusen wird zum Ergebnis „in einer Studie“, ein einzelner kleiner Versuch wird zur gesicherten Wissenschaft. Niemand muss dafür lügen – das passiert durch gewöhnliche Verkürzung, weil „Forschende beobachten bei 40 Personen einen Zusammenhang zwischen X und Y, Wirkrichtung unklar“ keine teilbare Schlagzeile ergibt.
Die Lösung ist nicht, der gesamten Gesundheitsforschung zu misstrauen oder jede Originalstudie selbst zu lesen. Es reicht, zu wissen, was ein paar konkrete Merkmale – Mensch oder Tier, Stichprobengröße, Vergleichsgruppe, Finanzierung, Replikation – tatsächlich aussagen, und danach zu fragen, bevor man eine Behauptung akzeptiert. Das ist dieselbe Haltung hinter unserer redaktionellen Richtlinie: klar zu sagen, wie gesichert eine Evidenz ist, statt ihr mehr Gewissheit zu leihen, als sie verdient. Dieser Leitfaden ist die Version davon, die Sie selbst anwenden können.
Die Evidenzhierarchie einfach erklärt
Forschende ordnen Evidenz nach der sogenannten Evidenzhierarchie: eine grobe Rangfolge von Studientypen nach dem Vertrauen, das sie stützen, vom schwächsten zum stärksten. Leitfäden zur evidenzbasierten Medizin der University of California, Davis, und der Icahn School of Medicine at Mount Sinai sowie ein 2022 in Hospital Pediatrics veröffentlichter Methodikartikel beschreiben alle Versionen derselben Stufenleiter: von Tierstudien und Expertenmeinungen ganz unten über Beobachtungsstudien und randomisierte kontrollierte Studien bis zu systematischen Übersichtsarbeiten und Metaanalysen an der Spitze (Wallace et al., 2022). Was jede Stufe konkret bedeutet:
Anekdoten und Expertenmeinungen
Noch vor den formalen Stufen gibt es Evidenz ganz ohne kontrollierten Vergleich: die Geschichte einer einzelnen Person, der klinische Eindruck einer Fachperson, oder Forschung an Zellen oder Tieren statt an Menschen. Nichts davon ist wertlos – ein eindrücklicher Erfahrungsbericht oder ein Laborbefund ist oft genau der Ausgangspunkt einer echten Hypothese. Aber nichts davon zeigt, ob ein Effekt real ist, weil nichts den tatsächlichen Effekt einer Behandlung vom Zufall, einer natürlichen Besserung, dem Placebo-Effekt oder der Auswahl trennt, wer überhaupt seine Geschichte erzählt. Hierher gehören auch Zell- und Tierversuche: Ein Ergebnis bei der Maus ist echte Evidenz bei der Maus und ein legitimer Ausgangspunkt für die Forschung am Menschen – aber keine Evidenz beim Menschen, bevor es nicht am Menschen getestet wurde.
Beobachtungsstudien (Kohorten- und Fall-Kontroll-Studien)
Hier hören Forschende auf zu vermuten und fangen an zu messen – ohne jedoch etwas zuzuteilen. Eine Kohortenstudie begleitet eine Gruppe über die Zeit und verfolgt, was mit denen geschieht, die eine bestimmte Exposition haben oder nicht (ein Ernährungsmuster, ein Beruf, eine Gewohnheit). Eine Fall-Kontroll-Studie geht den umgekehrten Weg: Sie beginnt bei Menschen, die ein Ergebnis bereits haben, und vergleicht deren Vorgeschichte mit der von Menschen ohne dieses Ergebnis. Beide Designs sind wirklich nützlich, manchmal die einzig ethische Option – man kann niemanden per Zufall zum Rauchen zuteilen – und so entdecken Forschende die ersten Muster, die weitere Untersuchung verdienen.
Ihre eigentliche Schwäche sind Störfaktoren (Confounder): Menschen mit einer bestimmten Exposition unterscheiden sich oft auch in anderer Hinsicht von jenen ohne, und genau das kann die wahre Erklärung für das Ergebnis sein. Deshalb kann eine gut gemachte Beobachtungsstudie zeigen, dass zwei Dinge zusammenhängen, ohne zeigen zu können, dass das eine das andere verursacht hat – eine Unterscheidung, die wir auch in unserem eigenen Artikel über die schwache Evidenz zwischen Alltagsstress und dem „Cortisolbauch“ im Blick behalten.
Randomisierte kontrollierte Studien
Eine randomisierte kontrollierte Studie teilt Teilnehmende per Zufall einer Behandlungs- oder einer Vergleichsgruppe zu – oft Placebo oder Standardbehandlung. Genau diese Methodenwahl macht RCTs stärker als Beobachtungsstudien, wenn es darum geht zu testen, ob etwas wirklich wirkt: Die zufällige Zuteilung gleicht Unterschiede zwischen den Gruppen aus, auch solche, an die niemand gedacht hat. Verblindung – wenn Teilnehmende und manchmal auch Forschende nicht wissen, wer welche Gruppe erhielt – schützt zusätzlich davor, dass Verzerrungen in die Ergebnisdarstellung einfließen.
Eine einzelne RCT bleibt eine einzelne Studie: gut geplant, kann sie trotzdem ein Zufallsergebnis liefern oder eines, das nur für die getesteten Personen, die Dosis oder das Produkt gilt – weshalb die nächste Stufe existiert.
Systematische Übersichtsarbeiten und Metaanalysen
Eine systematische Übersichtsarbeit ist eine strukturierte, kriteriengeleitete Zusammenfassung aller Studien, die eine festgelegte Schwelle zu einer bestimmten Frage erfüllen – keine persönliche Leseliste, sondern ein dokumentierter Such- und Auswahlprozess, den andere Forschende nachvollziehen können. Eine Metaanalyse geht weiter: Sie fasst die Zahlenergebnisse mehrerer ähnlicher Studien statistisch zu einer einzigen Schätzung zusammen, was die Unsicherheit um den wahren Effekt verringert und das Risiko senkt, dass ein einzelner Ausreißer das Ergebnis verzerrt. Die Leitfäden aus Davis und vom Mount Sinai sowie der Hospital-Pediatrics-Artikel stellen systematische Übersichtsarbeiten und Metaanalysen aus genau diesem Grund an die Spitze: Sie stehen für die Arbeit vieler unabhängiger Forschungsgruppen, nicht nur einer. (Es gibt auch formalere Versionen derselben Idee: Das GRADE-System bewertet die Sicherheit eines gepoolten Befunds als hoch, moderat, niedrig oder sehr niedrig, und das Cochrane-Instrument zur Verzerrungsbewertung prüft einzelne Studien auf konkrete methodische Schwächen. Diese vierstufige Leiter ist die Version davon in einfacher Sprache.)
Eine ehrliche Einschränkung, direkt von den Forschenden, die das untersuchen: Eine Hierarchie ist ein Ausgangspunkt, kein Ersatz dafür, die Studie selbst zu lesen. Die Autorinnen und Autoren von Hospital Pediatrics betonen, dass sie stets „im Kontext der Grenzen der jeweiligen Studie durch eine sorgfältige kritische Bewertung der einzelnen Arbeiten“ abgewogen werden muss – eine große, sorgfältig durchgeführte Kohortenstudie kann eine kleine, schlecht durchgeführte Studie übertreffen, auch wenn Studien auf der Leiter allgemein höher stehen (Wallace et al., 2022).
Fünf Fragen, die man bei jeder Gesundheitsstudie stellen sollte
Man muss nicht jede Studie fachlich einordnen können. Diese fünf Fragen führen meist zum selben Urteil.
Wurde es am Menschen, am Tier oder im Reagenzglas getestet?
Das ist die häufigste Lücke zwischen Schlagzeile und Realität. Ein Ergebnis „bei Mäusen“ oder „in Zellkulturen“ ist echte präklinische Evidenz und ein legitimer Grund, die Frage am Menschen weiter zu untersuchen – aber die meisten vielversprechenden Effekte aus Labor- oder Tierforschung bestätigen sich beim Menschen nicht auf dieselbe Weise. Steht bei einer Behauptung nicht „am Menschen“, gehen Sie davon aus, dass es das noch nicht wurde.
Wie viele Menschen haben teilgenommen?
Es gibt keinen universellen Mindestwert, aber die Logik ist einfach: Je kleiner der tatsächliche Effekt ist, den man nachweisen will, desto mehr Teilnehmende braucht man, um sicher zu sein, dass das Beobachtete kein Zufall ist. Eine Studie mit einem Dutzend Personen kann eine legitime Pilotstudie sein – sie kann nur einen moderaten Effekt nicht ausschließen und praktisch keine seltene Nebenwirkung erfassen. Behandeln Sie den Befund einer kleinen Studie als vorläufig, bis eine größere Studie ihn bestätigt.
Gab es eine Kontrollgruppe, und war sie randomisiert?
Eine Studie ohne Vergleichsgruppe kann nicht sagen, ob sich die Teilnehmenden ohnehin gebessert hätten. Eine Vergleichsgruppe, die nicht zufällig zugeteilt wurde, kann das oben beschriebene Confounder-Problem nicht vollständig ausschließen. Achten Sie auf beides zugleich – eine Kontrollgruppe und eine zufällige Zuteilung zu ihr –, bevor Sie ein Ergebnis als Beleg dafür werten, dass eine bestimmte Maßnahme ein bestimmtes Ergebnis verursacht hat.
Wer hat die Studie finanziert, und ist das offengelegt?
Seriöse Fachartikel legen Finanzierungsquellen und Interessenkonflikte offen, meist in einer Erklärung gegen Ende des Artikels. Eine von einem Unternehmen finanzierte Studie ist nicht automatisch falsch – einige der am besten replizierten Befunde bei Nahrungsergänzungsmitteln stammen aus industriefinanzierten Studien, die unabhängig geplant und ehrlich berichtet wurden. Aber es ist ein Muster, das man kennen sollte, und ein Grund, eine einzelne industriefinanzierte Studie gemeinsam mit unabhängiger Bestätigung zu gewichten statt für sich allein.
Wurde es repliziert, oder behauptet das nur diese eine Studie?
Eine Studie, so gut sie auch geplant ist, bleibt ein einzelner Datenpunkt. Echte Replikation bedeutet ein anderes Forschungsteam, idealerweise mit einem anderen Produkt oder einer anderen Population, das unabhängig zu einem ähnlichen Ergebnis kommt – nicht nur, dass irgendwo ein zweiter Artikel existiert. Ein so repliziertes Ergebnis verdient weit mehr Vertrauen als ein spektakuläres Ergebnis, das sonst niemand reproduzieren konnte.
Warnzeichen für eine schwache Studie
Ein paar Muster tauchen in der Gesundheitsberichterstattung so oft auf, dass sie für sich genommen Aufmerksamkeit verdienen:
- Eine einzelne kleine Studie wird dargestellt, als hätte sie etwas „bewiesen“. Starke Formulierungen („beweist“, „bestätigt“, „beendet die Debatte“) entsprechen fast nie dem, was eine einzelne Studie tatsächlich leisten kann.
- Tier- oder Laborforschung wird dargestellt, als gälte sie bereits für Menschen. Achten Sie auf das Wort „könnte“, das still viel Arbeit leistet – oder darauf, dass es zwischen Studie und Schlagzeile ganz verschwindet.
- Die Behauptung springt direkt von „hängt zusammen mit“ zu „verursacht“. Der häufigste Fehlschluss in der Berichterstattung über Beobachtungsstudien.
- Kein Hinweis auf Peer-Review – eine Pressemitteilung, ein Kongress-Abstract oder ein Preprint ohne begutachteten, veröffentlichten Artikel dahinter.
- Ein spektakuläres Ergebnis wurde von niemandem sonst repliziert, besonders wenn es einer größeren, bereits etablierten Evidenzlage widerspricht.
- Finanzierung und Autorenschaft liegen vollständig bei denen, die von einem positiven Ergebnis profitieren, ohne unabhängige Bestätigung.
- „Wunder“-, „Durchbruch“- oder „was Ärzte Ihnen nicht sagen wollen“-Formulierungen übernehmen die Arbeit, die eigentlich die Evidenz leisten sollte.
Nichts davon macht eine Studie automatisch falsch. Es sind Gründe, etwas weiterzulesen, bevor man die Version der Schlagzeile akzeptiert.
Anwendung auf reale Beispiele
Dieses Modell nützt nur, wenn man es auch anwenden kann. So sieht es bei zwei realen Gesundheitsbehauptungen aus, die beide an anderer Stelle auf dieser Website ausführlich behandelt werden.
Ashwagandhas wissenschaftliche Evidenz
Unser vollständiger Evidenzüberblick zu Ashwagandha ist ein wirklich gemischter Fall, was ihn hier so nützlich macht. Stressreduktion und Schlafqualität stehen ganz oben auf der Leiter: Eine Metaanalyse von 2025 fasste 15 randomisierte Studien und 873 Teilnehmende zu Stress und Cortisol zusammen, eine Metaanalyse von 2021 fasste 5 Studien und 400 Teilnehmende zum Schlaf zusammen – echte Replikation, auf dem Niveau systematischer Übersichtsarbeiten. Die Linderung von Wechseljahresbeschwerden steht eine Stufe tiefer: zwei wirklich positive Studien, aber beide im selben Land, mit demselben Markenextrakt, kostenlos vom selben Hersteller bereitgestellt – echte Evidenz, aber noch nicht unabhängig von einem anderen Team oder Produkt repliziert. Gewichtsabnahme und „Frauen über 50“ als eigene Kategorie stehen ganz unten: uneinheitliche oder schlicht fehlende eigene Studien. Eine einzige Pflanze, drei verschiedene Evidenzstufen je nach konkreter Behauptung – weshalb „ist es wissenschaftlich belegt“ die falsche Frage ist und „belegt durch welche Evidenz, für welche Behauptung“ die richtige.
Derselbe Überblick zeigt auch die Finanzierungsfrage in der Praxis: Mehrere der stärksten Studien erhielten ihren Extrakt kostenlos vom Hersteller, bei zweien waren Autorinnen oder Autoren direkt bei dem beteiligten Nahrungsergänzungsmittel-Unternehmen angestellt – alles von den Autoren selbst offengelegt, also das System, das so funktioniert, wie es soll, und kein Grund, die Ergebnisse zu verwerfen. Er hebt zudem eine Studie hervor, die bei ihrem primären Endpunkt keinen signifikanten Unterschied zu Placebo fand, ehrlich neben den positiven Studien berichtet statt verschwiegen – wie ein Evidenzüberblick aussieht, der nicht nur günstige Ergebnisse auswählt.
Der Cortisolbauch
Unser Artikel über den „Cortisolbauch“ zeigt den umgekehrten Fehler: eine populäre Behauptung, die auf schwächerer Evidenz ruht, als ihr selbstsicherer Ton vermuten lässt. Die Vorstellung, Alltagsstress hebe das Cortisol so weit an, dass gezielt Fett am Bauch abgelagert wird, ist für die meisten Menschen nicht gut belegt – Rexford Ahima, Endokrinologe an der Johns Hopkins Medicine, sagte es gegenüber WebMD unverblümt: „Die Vorstellung ist, dass chronischer Stress zu hohen Cortisolspiegeln führt, die eine übermäßige Ansammlung von Bauchfett antreiben – aber dieses Konzept wird durch die Evidenz nicht gestützt.“ Die Forschungslage ist eher gemischt als eindeutig negativ: Eine Metaanalyse von 2021 fand Bauchfett assoziiert mit einem langfristigen Cortisol-Marker (Cortisol im Haar), aber nicht mit einem kurzfristigen, während eine Übersichtsarbeit von 2015 die breitere Literatur als „nicht schlüssig“ bezeichnete. All diese Evidenz ist Beobachtungsevidenz – ein Zusammenhang, kein Beweis für eine Ursache – genau die Unterscheidung, auf der die zweite Stufe dieses Leitfadens beruht. Es gibt eine echte, krankhafte Form von erhöhtem Cortisol, die die Körperform verändert (das Cushing-Syndrom), aber das ist eine seltene, durch Laboranalysen bestätigte Erkrankung, keine Körperform, die man im Spiegel diagnostiziert. Dieselbe Ausgangsbehauptung, sehr unterschiedliche Evidenzstufen, je nachdem, was genau behauptet wird.
Wie The Wellness Voyage diese Methode anwendet
Wir sind keine Ärztinnen oder Ärzte, und dieser Artikel ersetzt keinen. Was wir durchgängig versuchen, ist zu beschreiben, wie gesichert eine Evidenz tatsächlich ist, statt ihr mehr Gewissheit zu leihen, als sie verdient – starke Evidenz wird als stark beschrieben, gemischte als gemischt, eine Forschungslücke als Lücke statt verschleiert. Das ist der Maßstab unserer redaktionellen Richtlinie, und genau das zeigen die beiden Beispiele oben: eine Pflanze mit wirklich starker Evidenz für manche Behauptungen und dünner für andere, und eine populäre Idee, deren Evidenz schwächer – und interessanter – ausfällt als die selbstsichere Version, die meist präsentiert wird.
Häufig gestellte Fragen (FAQ)
Was ist der Unterschied zwischen einer randomisierten kontrollierten Studie und einer Beobachtungsstudie? Bei einer randomisierten kontrollierten Studie teilen Forschende Teilnehmende per Zufall Gruppen zu – Behandlung gegen Placebo oder Standardbehandlung –, wodurch bekannte und unbekannte Unterschiede zwischen den Gruppen gleichmäßig verteilt werden. Bei einer Beobachtungsstudie teilen Forschende nichts zu: Sie messen, was ohnehin geschieht, und vergleichen Menschen, die sich natürlich unterscheiden. Deshalb eignen sich Beobachtungsstudien gut, um Muster zu entdecken, die eine genauere Untersuchung verdienen, sind aber schwächer darin, zu beweisen, dass eine Sache eine andere verursacht hat.
Bedeutet eine Veröffentlichung in einer Fachzeitschrift mit Peer-Review automatisch, dass eine Studie vertrauenswürdig ist? Nein. Peer-Review ist ein echter Qualitätsfilter – andere Forschende im Fachgebiet prüfen die Methodik vor der Veröffentlichung –, aber er ist eine Mindestanforderung, keine Garantie. Er sichert weder eine große Stichprobe noch ein randomisiertes Design, unabhängige Replikation oder Freiheit von Verzerrungen bei der Auswahl berichteter Ergebnisse. Eine kleine Einzelstudie und eine Metaanalyse mit 20 zusammengefassten Studien sind beide „peer-reviewed“, wiegen aber sehr unterschiedlich schwer.
Warum gelten systematische Übersichtsarbeiten und Metaanalysen als höherwertige Evidenz? Weil sie mehrere unabhängige Studien zusammenführen, statt sich auf eine einzelne zu verlassen. Jede einzelne RCT, auch gut geplant, kann ein Zufallsergebnis liefern oder eines, das nur für ihre Dosis, ihr Produkt oder ihre Population gilt. Eine systematische Übersichtsarbeit bündelt die Evidenz vieler Studien in einem dokumentierten Gesamtbild; eine Metaanalyse fasst deren Zahlenergebnisse statistisch zu einer einzigen Schätzung zusammen und verringert so die Unsicherheit um den wahren Effekt.
Ist eine Studie mit wenigen Teilnehmenden automatisch schlecht? Nicht automatisch, aber begrenzter. Eine gut geplante kleine Studie kann durchaus einen großen Effekt nachweisen und ist oft der notwendige erste Schritt, bevor eine größere Studie finanziert wird. Was sie nicht kann: einen moderaten Effekt ausschließen oder eine seltene Nebenwirkung erfassen – dafür braucht es eine deutlich größere Studie oder Jahre realer Anwendung. Behandeln Sie den Befund einer kleinen Studie als vorläufig, besonders solange er nirgendwo sonst repliziert wurde.
Woran erkennt man, ob die Finanzierung einer Studie ihre Ergebnisse beeinflusst haben könnte? Seriöse Fachartikel legen Finanzierung und Interessenkonflikte offen, meist gegen Ende des Artikels. Achten Sie darauf, wer die Studie bezahlt hat, wer das getestete Produkt bereitgestellt hat und ob eine Autorin oder ein Autor direkt beim beteiligten Unternehmen angestellt ist. Nichts davon macht ein Ergebnis automatisch falsch, aber es ist ein Grund, diese Studie gemeinsam mit unabhängiger Bestätigung zu gewichten – besonders wenn sämtliche positiven Ergebnisse zu einem Thema auf dieselbe Finanzierungsquelle zurückgehen.
Sollte man einer neuen Studie glauben, wenn sie mehreren älteren widerspricht? Meist nicht sofort. Eine einzelne Studie, die von einem etablierten Muster abweicht, ist häufiger ein statistischer Ausreißer, ein methodischer Unterschied oder ein Effekt ihrer speziellen Population als ein echter Umsturz alles Bisherigen – auch wenn echte Umstürze vorkommen. Vernünftiger ist es, darin ein Signal für weiteren Forschungsbedarf zu sehen, keinen Grund, die bestehende Evidenz zu verwerfen, solange sie nicht unabhängig repliziert wurde.
So ist dieser Leitfaden entstanden: Recherchiert und geschrieben vom Redaktionsteam von The Wellness Voyage, gestützt auf Leitfäden zur evidenzbasierten Medizin der Universitätsbibliotheken Davis und Mount Sinai, einen begutachteten Methodikartikel und eine öffentliche Gesundheitsinformationsquelle – alle unten aufgeführt und im Text verlinkt. Dieser Leitfaden ist ein Werkzeug für mehr Informationskompetenz, keine Ausbildung, die dazu befähigt, klinische Forschung eigenständig zu bewerten, und er ersetzt nicht den Rat einer qualifizierten medizinischen Fachkraft für Ihre eigenen Gesundheitsentscheidungen.
Medizinischer Hinweis: Dieser Artikel dient ausschließlich Informationszwecken. Konsultieren Sie immer eine qualifizierte medizinische Fachkraft, bevor Sie Änderungen an Ihrer Gesundheitsroutine vornehmen.
Quellen
- In brief: How is the quality of studies assessed? — InformedHealth.org, Institute for Quality and Efficiency in Health Care (IQWiG) — NCBI Bookshelf. https://www.ncbi.nlm.nih.gov/books/NBK390294/
- Levels of Evidence — Systematic Reviews Guide, Bibliothek der University of California, Davis. https://guides.library.ucdavis.edu/systematic-reviews/levels-of-evidence
- The Evidence Hierarchy — Evidence Based Medicine Guide, Levy Library, Icahn School of Medicine at Mount Sinai. https://libguides.mssm.edu/ebm/hierarchy
- Wallace SS, Barak G, Truong G, Parker MW. Hierarchy of Evidence Within the Medical Literature. Hospital Pediatrics, 2022;12(8):745-750 — PubMed. https://pubmed.ncbi.nlm.nih.gov/35909178/
- Wie werden Studien bewertet? — Gesundheitsinformation.de, Institut für Qualität und Wirtschaftlichkeit im Gesundheitswesen (IQWiG). https://www.gesundheitsinformation.de/wie-werden-studien-bewertet.html
Alle Quellen wurden am 18. September 2026 abgerufen.
Sophia Martinez
Eine Wellness-Forscherin, die sich auf evidenzbasierte Erkenntnisse konzentriert.